
美国一家政府机构公布了对中国最强大人工智能的结论:落后了八个月,时间越长差距就越大。互联网阅读了该方法并开始提出问题。
CAISI(NIST 内部的人工智能标准与创新中心)于 5 月 1 日发布了对 DeepSeek V4 Pro 的评估。结论是:DeepSeek 的开放重量旗舰产品“落后前沿约 8 个月”。
CAISI 还称其为迄今为止评估过的最有能力的中国人工智能模型。
评分系统
CAISI 不像大多数评估者那样平均基准分数。相反,它应用项目响应理论(一种来自标准化测试的统计方法)来评估每个模型的潜在能力,通过跟踪它解决了哪些问题和没有解决哪些问题,跨越五个领域的九个基准:网络安全、软件工程、自然科学、抽象推理和数学。
IRT 估计的 Elo 得分:GPT-5.5 为 1,260 分,Anthropic 的 Claude Opus 4.6 为 999 分。DeepSeek V4 Pro 得分约为 800 (±28),非常接近 GPT-5.4 mini 的 749 分。在 CAISI 的系统中,DeepSeek 与老一代 GPT mini 的得分比与 Opus 的得分更接近。
基准分数中的评分系统模拟了标准化测试对学生进行评分的方式——不是通过原始的正确百分比,而是通过对他们解决的问题和错过的问题进行加权,产生一个仅与同一评估中的其他模型相关的分数估计。一般来说,分数越多,模型越好,最好的模型分数成为衡量模型能力的参考点。
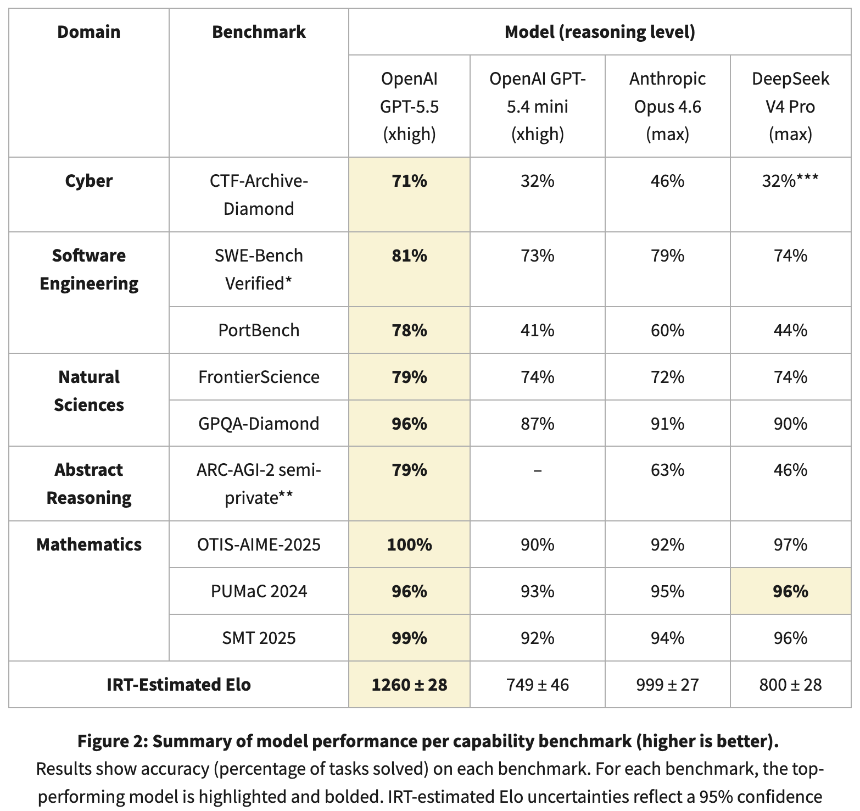
不可能重现 CAISI 的结果,因为九个基准中有两个是非公开的,而这两个基准中差距最大。例如,GPT-5.5 在 CAISI 的网络安全测试之一 CTF-Archive-Diamond 上得分为 71%,而 DeepSeek 得分约为 32%。
在公共基准测试中,情况发生了变化。 GPQA-Diamond(博士级科学推理,按正确百分比评分)将 DeepSeek 评为 90%,比 Opus 4.6 的 91% 落后一分。数学奥林匹克基准测试(OTIS-AIME-2025、PUMaC 2024、SMT 2025)将 DeepSeek 的得分定为 97%、96% 和 96%。在 SWE-Bench Verified(真正的 GitHub 错误修复,以解决百分比进行评分)上,DeepSeek 得分为 74%,GPT-5.5 得分为 81%。 DeepSeek 自己的技术报告声称 V4 Pro 与 Opus 4.6 和 GPT-5.4 匹配。
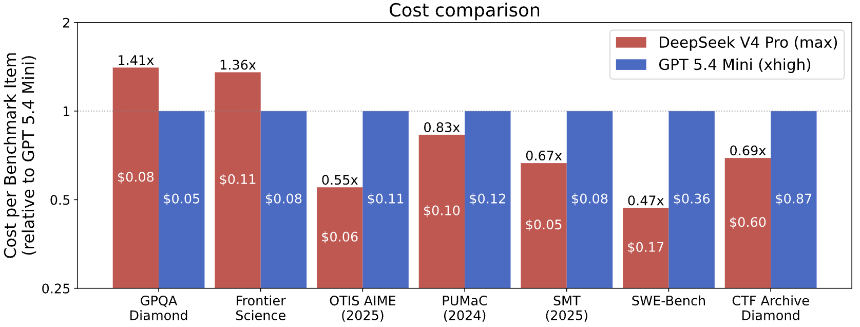
为了进行成本比较,CAISI 过滤掉了任何与 DeepSeek 相比表现更差或每个代币成本明显更高的美国模型。只有一款型号通过了标准:GPT-5.4 mini。这是整个美国边境,过滤为单个条目。
DeepSeek 在 7 个基准测试中的 5 个上表现更便宜,甚至击败了 OpenAI 最小且能力最差的 AI 模型。
反驳:差距更大还是更小?
批评 CAISI 的方法并不能完全证明 DeepSeek 的正确性。这位化名 Ex0bit 的人工智能开发人员直接反驳道:“不存在‘差距’,也没有人落后 8 个月。我们在美国的每一次收盘下跌中都受到了困扰,并在开放的权重中继续前进。”
There’s no ‘gap’, and no one’s 8 months behind. We’ve been trolled on every closed U.S drop and flexed on with open weights. https://t.co/dhbDb43b6P pic.twitter.com/kl0kAecmyO
— Eric (@Ex0byt) May 2, 2026
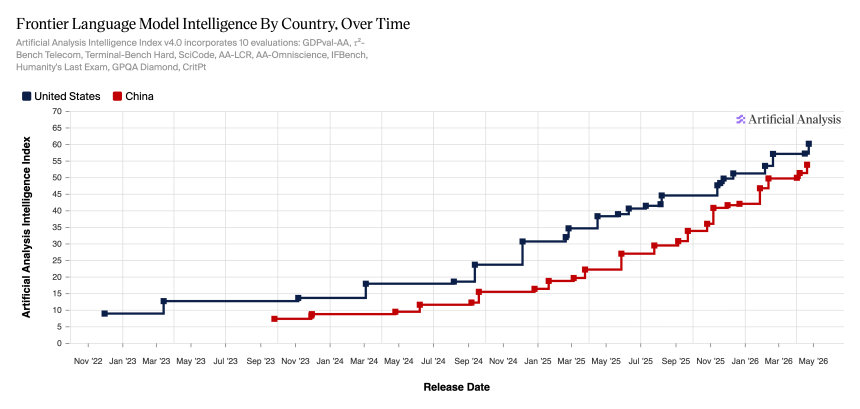
人工智能分析智能指数 v4.0(一个通过 10 项评估跟踪前沿模型智能的评级系统)显示,截至 2026 年 5 月,OpenAI 接近 60 分,DeepSeek 处于 50 分左右,比一年前压缩得更紧。
根据标准化基准,他们的方法显示差距实际上正在变小。
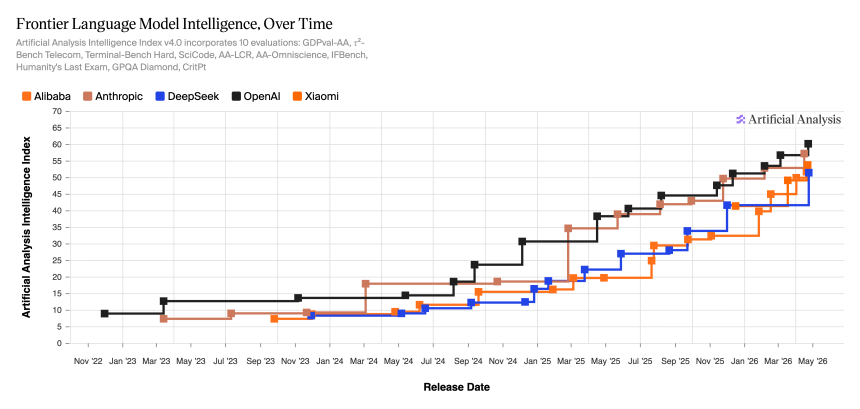
当 DeepSeek 于 2025 年 1 月首次出现时,问题是中国是否已经迎头赶上。 美国实验室纷纷做出回应。斯坦福大学 4 月 13 日发布的 2026 AI 指数报告称,Claude Opus 4.6 和中国的 Dola-Seed-2.0 Preview 之间的 Arena 排行榜差距正在缩小,目前差距仅为 2.7%。
CAISI 计划在不久的将来发布更全面的 IRT 方法论。