
百度(相当于中国的 Google)上周晚些时候正式发布了 ERNIE 5.1,其标题数字不容忽视:该模型的训练成本比同等规模的同类人工智能系统低约 94%。
从长远来看,训练前沿人工智能模型通常需要数数百万(如果不是数十亿)美元的计算费用。百度控制着中国超过 76% 的搜索市场,并在纳斯达克以 BIDU 交易,该公司声称,它以大约二十分之一的价格实现了同等水平的业绩。
这个技巧被称为“多维弹性预训练”。百度没有从头开始构建 ERNIE 5.1,而是从其现有的 ERNIE 5.0 架构(于 2026 年 1 月发布)中提取了优化的子网络,并将其压缩。总参数下降到原来的三分之一左右。活动参数(在对话期间实际起作用的参数)被削减了一半。结果是一个更精简的模型,继承了其较大父级的知识库,而无需重复完整的培训费用。
在 LMArena Search Arena(真实用户在实时网络搜索任务上比较 AI 模型的排行榜,根据人类偏好进行评分)上,ERNIE 5.1 得分 1,223,在全球排名第四,在所有中国模型中排名第一。它的代理能力——处理填写电子表格或自主浏览网页等多步骤任务的能力——超越了之前的中国基准制定者 DeepSeek-V4-Pro。
ERNIE在西方观察家看来可能是一个充满异国情调的名字,但它实际上是中国的一个主要模特。百度于 2023 年 8 月推出了 Ernie Bot,到当年 12 月,该聊天机器人在中国的用户数量达到了 1 亿,速度比大多数中国竞争对手都要快,但仍慢于 ChatGPT 两个月达到同一里程碑的全球纪录。
效率角度与 DeepSeek 在 2025 年 1 月对人工智能行业所做的事情相呼应。当这家中国初创公司发布 R1(该模型以低 98% 的查询成本与 OpenAI 的 o1 相媲美)时,它引发了 Nvidia 市值蒸发 6000 亿美元,并迫使每个主要人工智能实验室重新思考将计算投入解决问题是否是唯一可行的策略。 ERNIE 5.1 是一个不同类型的效率故事——在训练方面而不是在推理方面——但潜在的信息是相同的:中国实验室不断寻找用更少的资源做更多事情的方法。
训练后的流程也值得注意。百度构建了一个四阶段强化学习系统,称为 MOPD(多教师策略蒸馏)。百度并没有试图一次性教授所有技能——这往往会导致“跷跷板效应”,例如,数学成绩的提高会导致创意写作失败——而是并行训练代码、推理和代理任务的专家模型,然后将它们全部提炼成一个统一的模型。最后的在线强化学习阶段处理开放式对话和创意输出,保留蒸馏过程无法很好捕捉的内容。
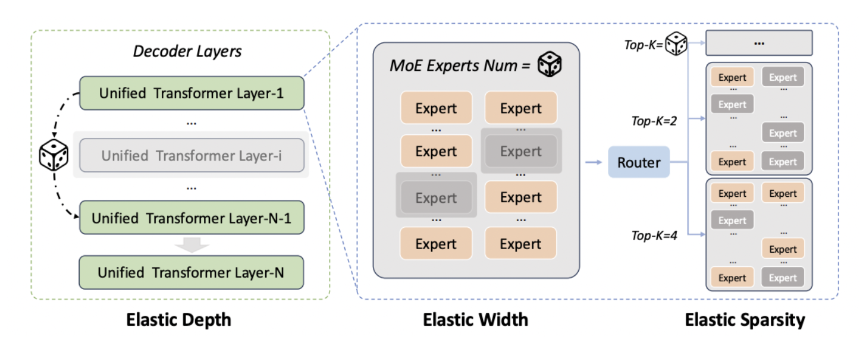
从理论上讲,这应该意味着所有技能都按照熟练程度进行分级,而不是优先考虑其中一项技能
在 GPQA(研究生级 Google 验证问答,衡量模型是否能够回答无法通过 Google 搜索的专家级科学问题的基准)上,ERNIE 5.1 的性能接近领先的西方闭源模型。在 AIME26(适应于 2026 年的美国数学邀请赛,该考试测试竞赛条件下的高级问题解决能力)上,该模型在使用工具辅助推理时得分为 99.6%,仅落后于 Gemini 3.1 Pro。
百度表示,ERNIE 5.1已经在中国10多个创意和代理平台上推出,包括人工智能角色扮演平台和短剧生成工具。该模型可通过 ernie.baidu.com 以及百度人工智能云平台上的 API 访问。
百度将于 5 月 13 日至 14 日在北京举办年度 Create 2026 开发者大会,计划展示 ERNIE 的最新行业应用。该事件将成为表明该公司打算如何积极将该模型推向企业和全球市场的下一个数据点。