

香港AI版权立法急刹车:opt-out搁浅,中国投资者须重估AI数据合规与Web3风险
导语:2026年9月底,香港特区政府被证实已把《2025年版权(修订)条例草案》从立法议程撤下。该草案原拟为AI训练数据开设“合法口子”,引入文本及数据挖掘豁免,并配合版权人选择退出机制。如今立法暂缓,转为先制定操作指引且无时间表。对关注香港国际创科与知识产权中心地位的中国投资者和研究者而言,这意味着未来一到两年,“用香港版权作品训练大模型到底合不合法”仍无确定答案。
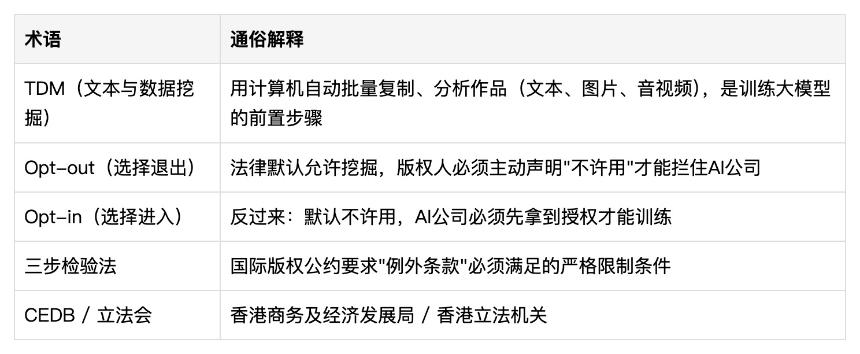
一、发生了什么
2024年7月,商务及经济发展局与知识产权署发布《版权与人工智能公众咨询文件》,核心议题是是否在《版权条例》第528章新增“文本及数据挖掘豁免”,明确为电脑数据分析、包括训练AI模型而复制版权作品不构成侵权。
按2025年2月提交立法会工商及创新科技事务委员会的咨询结果文件,政府原倾向方案为:豁免覆盖非商业和商业用途,但附加五项条件,包括合法取用、不得使用侵权复制品、留存并披露来源、市场已有特许计划时豁免不适用,以及给版权人选择退出选项。草案原计划2025年上半年提交立法会,但2025年8月被从议程移除;2026年《施政报告》和首个五年规划未再出现;2026年9月,据《南华早报》报道,官员确认草案暂缓,先制定操作指引,说明退出机制如何运作,但未给时间表。商务及经济发展局局长丘应桦表示,政府需先消化2024年咨询期间收到的不同意见。
二、为什么重要:AI训练数据的“原罪”
今天几乎所有大语言模型、多模态模型训练,都依赖对互联网海量版权作品的批量复制。复制本身通常受复制权控制,除非法律有明确例外。香港现行《版权条例》没有TDM一般例外,总部在香港、使用香港服务器或面向香港市场的AI公司批量抓取小说、新闻、图片、乐谱、论文用于训练,法律上处于“灰色但高风险”状态。
大陆法域类似:《著作权法》第24条合理使用为封闭式列举,没有“为AI训练”一项;司法实践对AI训练数据定性仍在摸索。美国依赖合理使用抗辩,OpenAI、Anthropic、Meta等面临诉讼,争点指向批量复制用于训练是否构成转换性使用。欧盟走得最远,2019年《数字单一市场版权指令》第4条规定商业TDM例外,但版权人可用机器可读方式保留权利,这是opt-out制度内核。全球主要法域均未把“AI训练=侵权”或“完全自由”写死,香港草案原本试图在美式开放与欧式强保护之间找亚洲位置。
三、opt-out卡在哪:两头不讨好
港府最初方案核心是欧盟式opt-out:默认AI公司可挖掘,版权人主动声明退出。对在线公开作品,设想以机器可读标记实现,类似robots协议或TDM Reservation Protocol。纸面上,这降低AI公司授权成本,也让版权人可一键退出。但2024年咨询期间,两方同时反对。
版权方和创作者认为机制太弱。消费者委员会指出,模型训练不可逆,数据一旦喂入模型,事后要求退出也几乎无法从权重中擦除,因此必须在训练前取得同意或尊重退出。IFPI香港分会、MPAA、AAP、IFRRO等要求退出机制必须有效、非负担,AI公司应公开声明尊重了哪些退出标记。他们担心大量小创作者、记者、摄影师、音乐人不知道设置机器可读标记,结果“默认被喂”,表面opt-out,实际对真正需要保护的人变成opt-in才能保护。
AI与科技产业则认为负担太重。香港资讯科技联会荣誉会长方保侨等指出,AI训练涉及多法域数据,本地机器可读退出清单若无全行业统一技术标准,执行成本极高;若“已有特许计划可适用”触发豁免失效,大型出版商可一边退出、一边另设高价授权池,AI公司要么买、要么违法。亚洲专利律师协会香港组提出,任何TDM例外都应明确覆盖生成式AI训练,且不应让版权人借此阻止作品进入训练集。香港工业总会建议谨慎推进,因为大模型训练动辄以TB计数据,合规义务会被放大到难以承受。最终,opt-out这条中间路线被两头都认为不可行:版权方要opt-in,科技产业要近乎自由使用。
四、操作指引不是法律
需要强调,操作指引没有强制力,不会改写《版权条例》第528章,也不能在法庭上作为免责依据。港府先不定硬规则,用指引、行业最佳实践、自愿性标准试探,等欧盟TDM退出登记库、英国AI版权改革报告、新加坡宽泛计算数据分析例外等格局更明朗后再决定。短期看,这对AI公司是“利好”,没有新硬约束;但对长期投资者,这是不确定性:没有法律,诉讼风险仍在,版权人仍可随时起诉在港训练模型的公司,香港作为“AI训练合法港”的叙事短期立不住。
五、横向比较:四把尺子
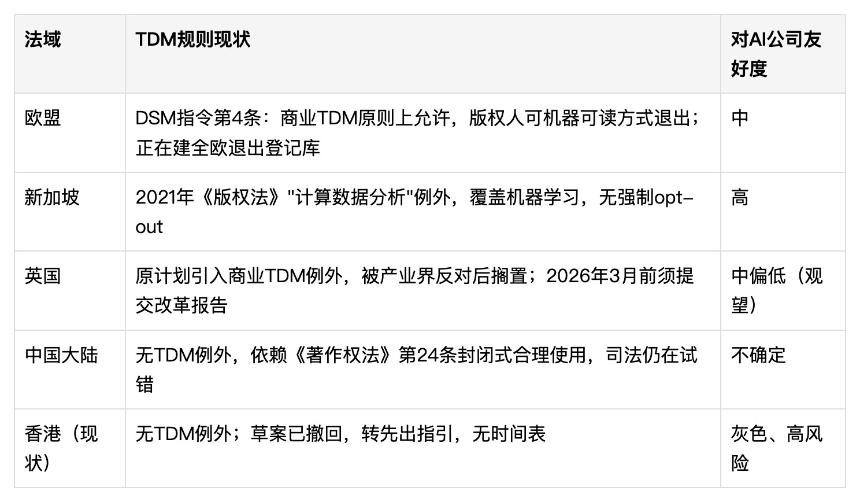
新加坡已用五年时间证明“宽例外”能吸引AI开发者;欧盟正用技术登记库把opt-out做实;英国在被创意产业说服后掉头。香港此刻既不选宽例外,也不选强保护,而是把决定无限期推后。
六、对中国投资者的三条判断
- 短期不要把“香港AI训练合法性”作为投资逻辑的一部分。在指引落地甚至立法重启前,基金若投在港训练大模型的公司,应在尽调中把训练数据版权风险作为独立、可量化负债,而非寄望港府马上立法豁免。若训练集含大量香港本地报纸、出版社、图像库作品,即便未来opt-out落地,也只能管未来,管不了已喂入模型的历史部分。尽调清单应单列训练数据来源、已授权占比、退出标记识别机制、IP侵权保险等。
- 关注“机器可读退出”标准这一技术中立战场。无论最终opt-out还是opt-in,版权人与AI公司的接口都将是机器可读协议、退出登记库、元数据声明。谁参与制定标准,谁掌握未来交易入口。合规科技、数据清洗、版权指纹、训练数据溯源公司,无论香港选哪条路,都是刚需。
- 大湾区联动要看清。香港法律搁置,深圳、上海、北京AI公司在训练数据合规上没有“法域套利”空间,因为模型一旦面向全球,欧盟、美国诉讼照样打过来。香港更可能作为国际仲裁与许可清算中心,而非训练避风港。中资美元基金和出海美元基金不宜在募资材料中把“香港法域对AI训练友好”当卖点,可关注香港在国际版权许可清算、跨境授权、AI生成内容登记上的卡位机会。
七、对研究者的提示
对知识产权法、科技法、AI治理学者,这部草案撤退是亚洲法域在“创新—保护”之间摇摆的样本。值得追踪:操作指引法律性质是什么?若与未来立法不一致,能否作为合理信赖抗辩?香港会否转向新加坡式“宽例外、无opt-out”?当训练不可逆时,“事后退出”在规范设计上是否伪命题?
八、接下来盯三件事
- CEDB/知识产权署何时发布首版操作指引草案,公众咨询期多长;
- 2027年《施政报告》或香港第二个五年规划中,草案是否重新出现;
- 欧盟全欧TDM退出登记库进展,它很可能成为香港指引直接参照系。
结语:香港没有否决AI训练数据使用,只是把“规则到底是什么”暂时藏进抽屉。在这三件事明朗前,投资者与研究者都应为不确定性定价。
参考链接
- 南华早报报道(经GMAsia转引):https://gmasia.ai/news/hong-kong-delays-ai-copyright-law-to-focus-on-guidelines-first
- 立法会工商及创新科技事务委员会文件:https://www.legco.gov.hk/yr2025/chinese/panels/ci/papers/ci20250218cb2-240-4-c.pdf
- 港府《版权与人工智能公众咨询文件》:https://www.cedb.gov.hk/assets/resources/cedb/consultations-and-publications/Chi_Copyright%20and%20AI%20Consultation%20paper%20(2024.07.08)_v1.pdf
- 知识产权署英文咨询文件:https://www.ipd.gov.hk/filemanager/ipd/en/share/consultation-papers/Eng-Copyright-and-AI-Consultation-Paper-20240708.pdf
- AI Law Review事件评述:https://www.reviewofailaw.com/Tool/Evidenza/Single/view_html?id_evidenza=6470
- 欧盟委员会TDM退出登记库可行性研究:https://digital-strategy.ec.europa.eu/en/library/new-feasibility-study-introducing-eu-level-registry-text-and-data-mining-opt-out
- WIPO:新加坡计算数据分析例外:https://www.wipo.int/edocs/mdocs/mdocs/en/wipo_ip_conv_ge_24/wipo_ip_conv_ge_24_ss04.pdf
- 中国保护知识产权网:英国AI版权例外动态:https://ipr.mofcom.gov.cn/article/rgzhn/202603/1995427.html
- Legal 500:香港AI法律概览:https://www.legal500.com/guides/chapter/hong-kong-artificial-intelligence/