

彭博终端上,来自 Silicon Data、Ornn 和 Compute Desk 的 GPU 价格指数同时显示,但三家对一台 H100 到底值多少钱无法达成一致。大多数 GPU 算力通过私人双边合约以折扣价流转,公开指数难以有效定价。与此同时,一个运行着 32 万张 GPU 的加密网络,正在用真实市场交易为 GPU 算力定价。
为什么没人能为 GPU 定价?
当你为一台 H100 支付每小时 3 到 10 美元时,实际租到的是什么?在 Vast.ai 上,3 美元买到的是某人备用服务器机架里的一张 GPU 卡,通过普通以太网连接,对机器正常运行时间没有任何保证。另一边,同样的 H100 每小时要 10 美元,但它位于 Oracle Cloud,这是专门建造的设施,GPU 之间通过每秒 400 吉比特的 InfiniBand 互联,并有一整支工程师团队全天候监控。
价格高出三倍多,是因为 Oracle 卖给你的是一整套计算环境,而不只是对芯片的访问。仅这一差别,就让同一块硅片在不同提供商之间的价差达到 6.7 倍。价差存在,是因为 GPU 本身不是产品。GPU 只是更大服务中的一种原料。一座建筑里用 NVLink 和 InfiniBand 连接的 512 张 GPU 集群,可以跑分布式训练任务,而散落在五个低成本数据中心的 512 张独立 GPU 即使芯片数量相同,也无法高效完成。这些是完全不同的产品,只是碰巧共用一个名字。
债务市场已经看明白了这一点。CoreWeave 多次以同一类 H100 硬件为抵押借款。当这笔债务有 Meta 的长期照付不议协议背书时,利率约为 5.9%。但当公司以同样硬件借款、却没有合同包装时,要付 9.75%。把利率拉开 400 个基点的,完全是硬件之上的客户合同。这反映出债券市场认为自己实际在承保的是什么,而不是 GPU 本身。
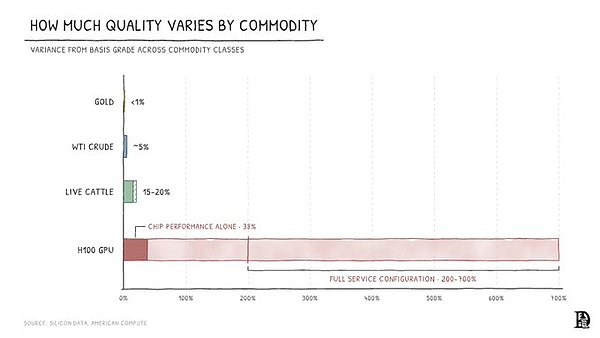
期货合约的整个逻辑,取决于能够对标的产品分级。黄金相对伦敦合格交割金条的偏差不到 1%,WTI 原油允许约 5% 的偏差,活牛的质量带控制在 15% 到 20%。但当 Silicon Data 对 11 个不同设施的 3500 张 H100S GPU 做基准测试时,性能差异达到 38%。一旦计入网络、正常运行时间、冷却等完整服务配置,价差会膨胀到 200% 到 700%。地球上没有任何分级表能吸收七比一的质量范围。
当你试图在无法分级的东西之上建立交割机制时,会发生教科书式的逆向选择。如果卖方在期货合约下欠你 1000 个 H100 小时,他们可以交割高端集群上的时间,也可以交割每小时 3 美元的零散低成本现货实例。两者在技术上都能满足合约。而他们每次都会交便宜的那个。George Akerlof 在 1970 年关于柠檬市场的论文中描述了这一现象:当买方在交割前无法验证质量时,最差版本的产品会系统性地挤出每一个更好的版本。
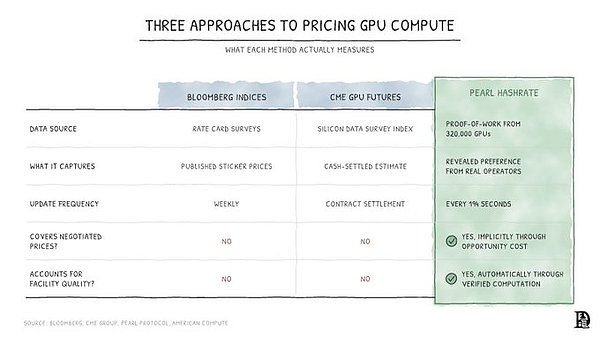
CME 计划于 2026 年 10 月 5 日推出的 GPU 期货合约完全避免实物交割,而是以现金结算对照 Silicon Data 的调查指数。只不过该指数收集的是云提供商在公开费率卡上公布的价格,而大买家实际谈判出的价格通常低 40% 到 50%。结算机制是基于标价的估计,而市场上大多数大买家明显并不按这个价格支付。此外,算力是流量商品。没人在那一瞬间买下的 GPU 小时就永远消失了。任何 GPU 算力的定价信号都必须实时运作。
Pearl:让矩阵乘法成为价格信号
获取这些知识的唯一途径,是真实规模下、对手方有真金白银押注的真实交易。这就把我们带到一个同样从电力中演化出来的方案:一个源自比特币的网络,目前有 32 万张 GPU 指向它。
比特币矿工运行 SHA-256 哈希。这种计算只为一个目的存在:证明矿工烧掉了一定量的电力。一旦该证明被记入区块,哈希或所做的工作就毫无价值。它不能被重用、改作他用,或卖给区块链之外的任何人。问题在于,成千上万的矿工为每个区块做这项工作,但网络只接受一名矿工的一个区块。其余工作被丢弃。每一个曾被挖出但未被网络接受的 SHA-256 哈希,都代表一个本可以做商业上有价值之事的 GPU 周期,而在 2026 年,“商业上有价值的 GPU 工作”只意味着一件事:AI 算力。
Pearl 是一条试图让 GPU 算力具备商业价值的 Layer 1 区块链。它继承了自 2009 年以来保障比特币的同一套工作量证明共识和难度调整。但 Pearl 矿工运行的不是 SHA-256 哈希,而是在 GPU 上做矩阵乘法。为什么矩阵乘法有价值?因为这是你向 ChatGPT 提问时得到所有答案的基础。当 Nano Banana 根据文本提示渲染图像、当公司用专有数据微调语言模型、或当自动驾驶汽车实时处理摄像头画面时,同样如此。过去三年消耗硅谷注意力和数千亿美元资本的每一个大语言模型和每一个扩散模型,其计算核心都运行在矩阵乘法上。
那安全性呢?SHA-256 没有捷径。不做完整计算,就无法产生输出。矩阵乘法则不同,模式可以让矿工用很少的努力算出答案,从而削弱工作量证明的有效性。Pearl 使用一种叫 NoisyGEMM 的机制来确保矿工保持诚实。矿工在开始任何工作之前,先对输入矩阵做出承诺。协议随后向已承诺的矩阵添加随机噪声,消除矿工可能计划的任何对称性。矿工在加噪版本上运行完整的矩阵乘法,在 GPU 上逐块进行。每个输出块被哈希,并对照网络的难度目标检查。如果某个块的哈希低于目标,矿工就赢得区块奖励。
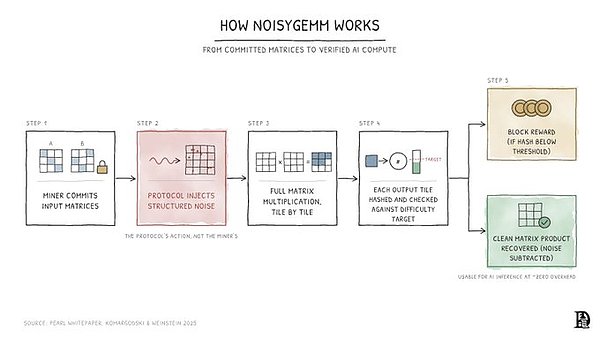
引入噪声,阻止了矿工不实际工作就获得奖励。然而,正是这种噪声,也意味着我们得不到原始工作负载的答案。Pearl 的解决办法是给噪声一个已知结构。这让它在矿工完成乘法后剥离噪声,清理成本很小且廉价。
当一张 GPU 挖 Pearl 时,网络测量这台机器在协议目标的 194 秒区块间隔内,于当时存在的电力、冷却和网络条件下,实际完成了多少次矩阵乘法。一台位于冷却良好的企业设施中的 H100,每个区块完成的工作可能多于同一芯片放在某人车库里、用消费级以太网且气流不佳的情况。Pearl 自动捕捉这一差异,这是任何按型号平均的价格指数都做不到的。
现在把这扩展到数十个地理区域的 32 万张 GPU,总算力就成为有史以来最大的真实世界 AI 算力连续基准,每 194 秒更新一次,无需任何人做调查或发布费率卡。
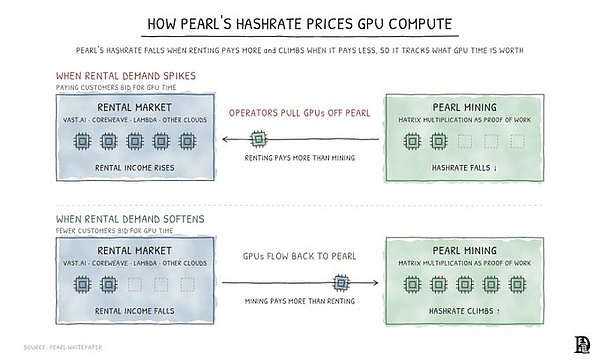
算力也跟踪配置。这 32 万张 GPU 中的每一张,都可以在 Vast.ai、CoreWeave、Lambda 或数十家争夺 AI 客户的其他云提供商上赚取租赁收入。这些运营商选择把机器指向 Pearl。当世界上某处对 GPU 算力的真实需求飙升时,运营商把机器从 Pearl 上撤下,去服务付费客户,算力下降。当需求走软、租赁收入下降时,这些 GPU 回流,算力上升。网络的难度调整对这些迁移做出反应,方式与比特币难度自 2009 年以来对挖矿经济变化做出的反应相同。
差别在于,比特币矿工权衡的是他们将承担的电力成本,与出售所挖比特币能赚到的收益。2023 年 8 月德克萨斯热浪期间,Riot Platforms 关闭了大部分矿机,收取了 3170 万美元电力信用,是当月挖出的 333 枚比特币价值的三倍多。当足够多的矿工做出这一选择时,算力下降,难度每 2016 个区块重新调整,以确保区块大约每 10 分钟产出一个。
GPU 在 Pearl 与租赁市场之间的这种流动,产生了 GPU 算力持续更新的均衡价格。算力高且上升,意味着公开市场上计算机便宜,因为运营商发现挖 Pearl 比出租更划算。算力下降,意味着某处有人开始支付足够高的价格,把机器拉走。而这一价格信号来自显示性偏好,来自成千上万 GPU 运营商用自己的硬件和自己的钱选择做什么。它不来自云提供商市场团队决定印在费率卡上的东西,而那正是彭博指数和 CME 结算机制一直以来所能接触到的全部。
商业化与挑战
Together AI 是第一个在此基础上做商业化的。2026 年 5 月 15 日,它宣布一个运行在 Pearl 挖矿网络上的推理端点,以比标准云费率低 25% 以上的价格提供 Gemma-4-31B-it-Pearl。经济性成立,是因为通过 Together 端点提供推理的 GPU 同时在挖 Pearl,因此挖矿收入抵消了部分运营成本,Together 可以低于更广泛市场定价,而无需从自己的利润中补贴差额。
Pearl 网络的大部分尚未服务来自付费推理客户的这一水平需求,弥合这一差距显然是前方的挑战。但定价并不依赖它。它依赖机会成本是真实的,而这一机会成本对这 32 万台机器中的每一台,以及推理市场中的其他若干台都存在。
GPU 算力市场是一个年规模数千亿美元、却没有可靠价格的市场。彭博指数试图跟踪它,但在任何给定一周都无法给出准确方向。CME 计划于 2026 年 10 月 5 日推出 GPU 期货,以现金结算对照大买家明显不支付的标价。但一个基于比特币代码库、仅五个月长的工作量证明网络,有 32 万张 GPU 持续决定是挖矿还是在公开市场上出租产能,而这些决策的汇总,正在产生 GPU 算力行业有史以来最接近准确价格的东西。