

原文作者:林晚晚
2014年,百度研究院迎来一位中科院自动化所的博士生实习生,他来自河南县城。彼时,他给自己算过一笔账:毕业后最理想的去处是IBM,写Java,年薪28万。
2026年春节,一款名为OpenClaw的Agent工具全球爆火,其开发者生态依赖底层大模型支撑。其中一个模型以其速度和成本优势,一周内在OpenRouter平台上“吞掉”1.44万亿Token,登顶全平台第一。
这个模型叫M2.5,它背后的公司叫MiniMax。
上市仅两个月,其股价从165港元飙升至1300港元,市值突破3000亿港元。而彼时,这仍是一家年收入不足8000万美元的公司。
创造MiniMax的人,正是十二年前的那个实习生——闫俊杰。
提前一年多的赌注
2021年春节,闫俊杰回河南老家过年。探望外公时,老人提起想写一本回忆录,记录自己80年的人生,但因不会打字、难以组织语言而数次搁置。
那一刻,在AI行业深耕十多年的闫俊杰突然意识到,自己所做的技术,即便已在产业中落地,帮助了许多企业,但对一位想写回忆录的普通老人而言,却毫无用处。
这个细节后来被反复提及,它朴素地解释了闫俊杰的动机:让普通人真正用上AI。这股执念,驱动了他日后一系列反直觉的决策。
2021年底,他从商汤科技离职。其时,商汤正筹备港股上市,他身兼副总裁、研究院副院长、智慧城市事业群CTO等要职,却在公司价值高点选择离开。
ChatGPT于2022年11月才发布。
而MiniMax,成立于2021年12月。
这个时间差,成为后来一切的基础。闫俊杰后来坦言,若非起步早,在后来“明星研究员和大厂AI背景更受欢迎”的融资环境中,MiniMax恐难脱颖而出。
他的背景并无光环:父母是普通人,县城高中毕业,考入东南大学数学系,继而在中科院自动化所读博,清华博士后,后加入商汤。没有海外背景,也无显赫人脉。
在百度实习期间,他与地平线创始人余凯有过交集。余凯后来评价,学术能力可训练,但能将AI技术工程化落地者,凤毛麟角,闫俊杰是其中之一。
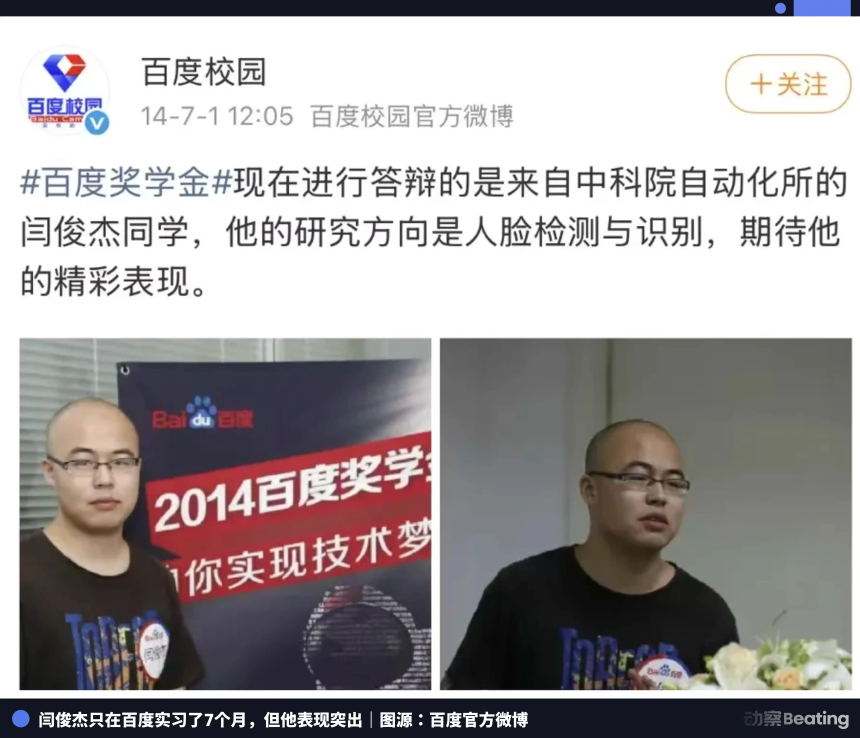
在商汤的七年,他从实习生升至副总裁。2018年,他带队在资源紧缺的情况下研发出“All for One”模型算法,于竞标中反超旷视与依图,夺得行业第一。其“看论文速度奇快,直取精华”的风格,后来成为MiniMax的公司文化。
他将公司命名为MiniMax,源自博弈论中冯·诺依曼的极小化极大算法。其解释是:做决策需先防范最坏风险,再选取相对最优解。
一张奇特的股东表
2021年12月,MiniMax完成3100万美元天使轮融资,投前估值1.7亿美元。投资方包括米哈游、IDG、高瓴、云启。
米哈游的入场颇为特别。闫俊杰与米哈游董事长刘伟私交甚笃,天使轮即进入,刘伟至今仍在MiniMax董事会担任非执行董事。米哈游本身也是其客户,游戏内NPC对话、剧情生成均采用MiniMax模型。
天使轮后,公司遭遇惊险插曲。2023年3月,硅谷银行破产,MiniMax当时所有资金存放于此。这是创业初期最危险时刻,但他们挺了过来,并于两个月后获得2.57亿美元A轮融资,估值达11.57亿美元。
随后,股东名单愈发耀眼:阿里、腾讯、红杉相继入局。上市前,公司累计完成近15亿美元7轮融资,估值42亿美元。IPO后,阿里持股12.52%,成为最大外部股东。
闫俊杰早期融资有个习惯:只与投资机构的最高决策者面谈。他见过红杉沈南鹏、高瓴张磊。
但股东表中还有一位关键人物:贠烨祎。
1994年出生,约翰·霍普金斯大学电子工程本科毕业,辅修经济学与数学。2017年加入商汤,从事融资与战略投资,一年后升任CEO徐立的行政助理兼战略部总监,深度参与了商汤从早期到上市的全过程。
2021年,她与闫俊杰共同创业。
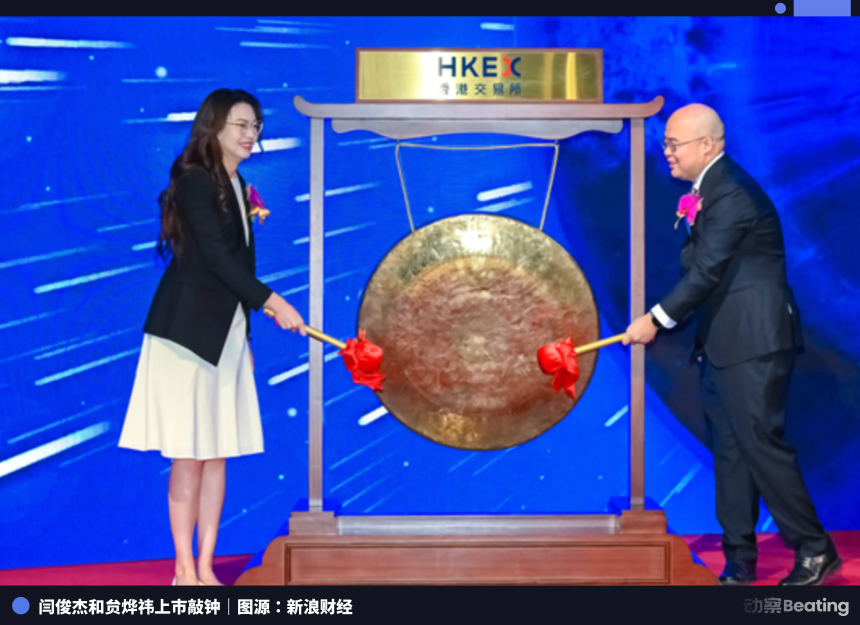
投资人评价她“干练、有气场、执行力强,有种超出年龄的成熟”。她与闫俊杰分工明确:一个定义技术愿景,一个将愿景转化为资金与资源。闫俊杰可沉浸技术,不拘小节;而市场、资本、全球化则是贠烨祎的战场。
上市敲钟之日,二人同台。时年31岁的贠烨祎,身价超过40亿港元。
385人与1%的预算
MiniMax上市时,全公司仅385人,平均年龄29岁。
公司从成立至2025年9月,累计花费约5亿美元。同期,OpenAI的花费在400亿至550亿美元之间。
对比近乎荒谬。他们用不到对手1%的资金,打造出一家全球领先的全模态AI公司。省钱只是结果,核心在于将AI效用发挥到极致:公司80%的代码由AI完成,内部称AI为“实习生”,这些“实习生”权限极高,可直接访问代码库、修改线上环境,在飞书中简单沟通、审核后即可上线。
这种效率带来了极高的人均产出。
产品战略上,他们从一开始就押注全模态:语言、视频、语音、音乐四路并进。当旁人效仿ChatGPT专攻对话时,闫俊杰坚信多模态融合是持续提升智能的前提,也是下一代模型的入场券。
2023年夏,他做出更激进决定:将80%的算力与研发资源,全部压注MoE(混合专家系统)。
当时,国内主流仍在迭代稠密模型,MoE被视为“前沿但不成熟”。闫俊杰的逻辑直接:若要服务千万乃至亿级用户,生成Token的成本与延迟,稠密模型根本无法承受。不做MoE,规模上不去,一切皆空。
2024年初,MiniMax发布了国内首个MoE大模型。
产品端,他们亦未局限于国内竞争。C端推出星野(国内)与Talkie(海外),主打AI陪伴;海螺AI专注视频生成,在2024年下半年连续六个月位居全球视频生成应用月活第一。
最新数据显示:公司拥有2.36亿用户,覆盖200多个国家和地区,海外收入占比73%。B端服务21.4万企业客户与开发者,其模型已部署于Google Vertex AI、微软Azure、AWS等平台,并成为Notion首个开源模型选择。
今年2月,公司年度经常性收入(ARR)突破1.5亿美元,M2系列单日Token消耗量达去年12月的6倍,其中编程方向增长超10倍。
这正是市场给予其近200倍市销率的原因。
但一组数据需拆解:财报显示,C端业务毛利率仅4.7%,而B端高达69.4%。公司67%的收入来自C端,但其对毛利贡献微乎其微。去年四季度,C端毛利率已跌至约2.1%。整体毛利率能从12.2%提升至25.4%,主要得益于B端收入占比在季度内快速提升。
这道盈利难题,尚未完全解答。
“大山不是不能翻越”
2025年6月,MiniMax发布M1模型。闫俊杰在朋友圈写道:“第一次感觉到大山不是不能翻越。”
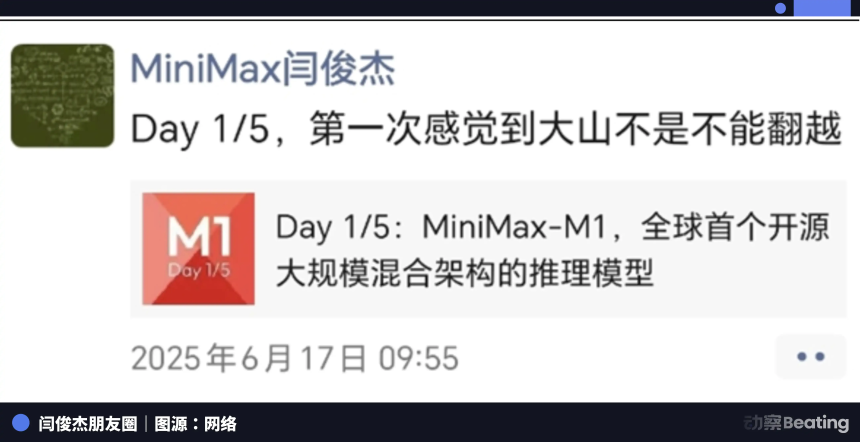
这句话的背景是,中美头部模型技术能力或许仅差5%,但这5%却让海外公司占据了价值高出10倍的场景,收取高出10倍的价格,最终形成近百倍的商业化差距。OpenAI最新估值超7000亿美元,而MiniMax上市市值约800亿港元,不足百亿美元。
闫俊杰曾判断,全球未来将出现五家顶级AGI公司,其中至少两家来自中国,甚至可能有一家位居第一。
今年1月9日上市后,他于1月19日受邀出席总理主持的专家企业家座谈会,成为继DeepSeek创始人梁文锋之后,第二位与会的中国大模型创始人。
3月2日,公司发布首份年报,港股股价应声大涨。
财报会上,闫俊杰花费大量时间阐述一个转型:MiniMax要从“大模型公司”迈向“AI时代的平台型公司”。
他为平台价值定义了一个公式:智能密度 × Token吞吐。他认为,互联网时代的平台是流量入口,AI时代的平台则是能定义智能边界、并攫取商业红利的公司。Google在做,OpenAI在做,他们也要做。
他面对的对手,体量是其数十倍。
港股上市将他推入了新战场。季度财报、分析师、市值压力,这些与写代码全然不同。二级市场不相信情怀,只认数字。C端故事能否转化为利润,B端增速能否维持,M3何时发布,这些问题,每个季度都需回答。
然而,将视野拉远,MiniMax的故事不止于一家公司。
美国近年来在芯片上不断收紧限制:A100、H100、H800相继限售。逻辑直白:扼住算力,便扼住了AI的喉咙。
中国公司被迫走上一条迥异之路。
DeepSeek用H800跑出了接近H100的效果。MiniMax用5亿美元完成了OpenAI耗费数百亿美元才达到的成就。闫俊杰2023年all in MoE,正是因手中有限的算力卡无法支撑亿级用户的推理需求。M2.5连续工作一小时成本仅1美元,是GPT-5的二十分之一。混合注意力架构、线性注意力、CISPO算法……诸多创新皆是被“逼”出来的。
芯片封锁的本意是拉大差距,实际却将中国AI公司逼入了一条低算力、高效率的进化路径。
钱少、卡少、人少,反而逼出了极致的工程能力与架构创新。
这与华为攻克芯片的逻辑如出一辙:封锁一项能力,就在其他维度补足,并在这一过程中长出对手未曾拥有的东西。
OpenAI现有超4000人,2025年烧掉80亿美元现金,计划到2030年投入6000亿美元算力。MiniMax仅385人,累计花费5亿美元。
胜负尚未可知。但至少现在,赌MiniMax会输的人,越来越少了。
2014年那个在百度实习的河南博士生,大概未曾料到,十二年后他所站的位置,连接的是一场关乎国运的技术竞争。
而他,选择继续奔跑下去。